

 27浏览
一、摘要
在文生图(Text-to-Image,T2I)任务中,统一多模态模型(Unified Multimodal Models,UMMs)的测试时扩展(Test-Time Scaling,TTS)方法主要依赖于搜索或采样策略。这些策略仅能产生单次生成的实例级别优化,限制了模型利用先前的推理过程并从相似提示词中积累知识的能力。为了克服这些局限性,我们提出了 Meta-TTRL,一种元认知测试时强化学习框架(Metacognitive Framework for Test-Time Reinforcement Learning,Meta-TTRL)。Meta-TTRL 可以在 UMMs 内嵌的元知识的监督指导下执行测试时的参数优化,从而在测试阶段实现框架的自我改进和能力提升。实验表明,Meta-TTRL 在三个代表性的 UMMs(包括:Janus-Pro-7B、BAGEL 和 Qwen-Image)上表现出良好的泛化能力。它们在组合推理任务和多个文生图基准测试中均取得了显著的收益。我们也提供了全面的分析,以探索测试时强化学习(Test-Time Reinforcement Learning,TTRL)在 UMMs 文生图生成中的潜力。我们的分析进一步揭示了元认知协同(metacognitive synergy)是实现 TTRL 和框架自我改进的关键支撑。
二、引言
统一多模态模型(UMMs)主要研究如何使用同一个架构实现多模态理解和图像生成。目前主流的 UMMs 主要有三种技术路线:将文本和视觉统一做词元预测的自回归方法(如 Janus-Pro-7B)、将语言模型与扩散模块结合的方法(如 Qwen-Image),以及在单一 Transformer 内融合语言建模与扩散模型的方法(如 BAGEL)。这种大一统的架构让 AI 既能“读懂”复杂的文字指令,又能灵活地画出高质量图像。
然而,想让这些模型变得更聪明,单纯靠“做大模型”会带来极其高昂的算力成本。为此,研究者们转向了测试时扩展(Test-Time Scaling,TTS)技术——也就是在用户实际使用模型(测试阶段)的时候,多花一点推理算力来换取更好的生成效果。这种技术的常见做法有两种:一种是“海选模式”(并行采样),让模型一次画很多张图,再用裁判模型挑出最好的一张;另一种是“打磨模式”(顺序迭代),让模型在多轮推理中不断评估和修改自己的画作。
但现有的 TTS 方法存在一个致命的痛点:由于在测试过程中模型的参数是锁定的,它只能实现单次推理的单实例优化,而不会“举一反三”。哪怕它这次费尽周折画对了一道难题,经验也没有写进“脑子”里。下次遇到类似的提示词,它还是必须从头再算一遍,中间过程甚至会犯历史性的错误。
为了解决这个问题,测试时强化学习(Test-Time Reinforcement Learning,TTRL)应运而生。它主张把测试阶段积累的经验转化为学习信号,现场更新模型参数。虽然 TTRL 在纯文本推理和图文理解上已经初见成效,但在文生图(T2I)领域却几乎是一片空白。本文提出的 Meta-TTRL 正是为了填补这一空白:它不需要借助任何外部的裁判模型,而是利用 UMM 自身的“看图理解”能力来监督自己的“画图”能力,让模型在测试使用过程中实现真正的自我进化。
三、方法
问题定义
给定测试阶段的文本提示词空间 和生成图像空间 ,当输入一个复杂的测试提示词 ,我们的目标是在没有任何外部人工标注或外部专用奖励模型的干预下,利用模型在测试阶段产生的反馈信号,动态更新生成策略的参数 ,进而持续提升模型在当前及后续相似任务中的图像生成质量。
核心思路
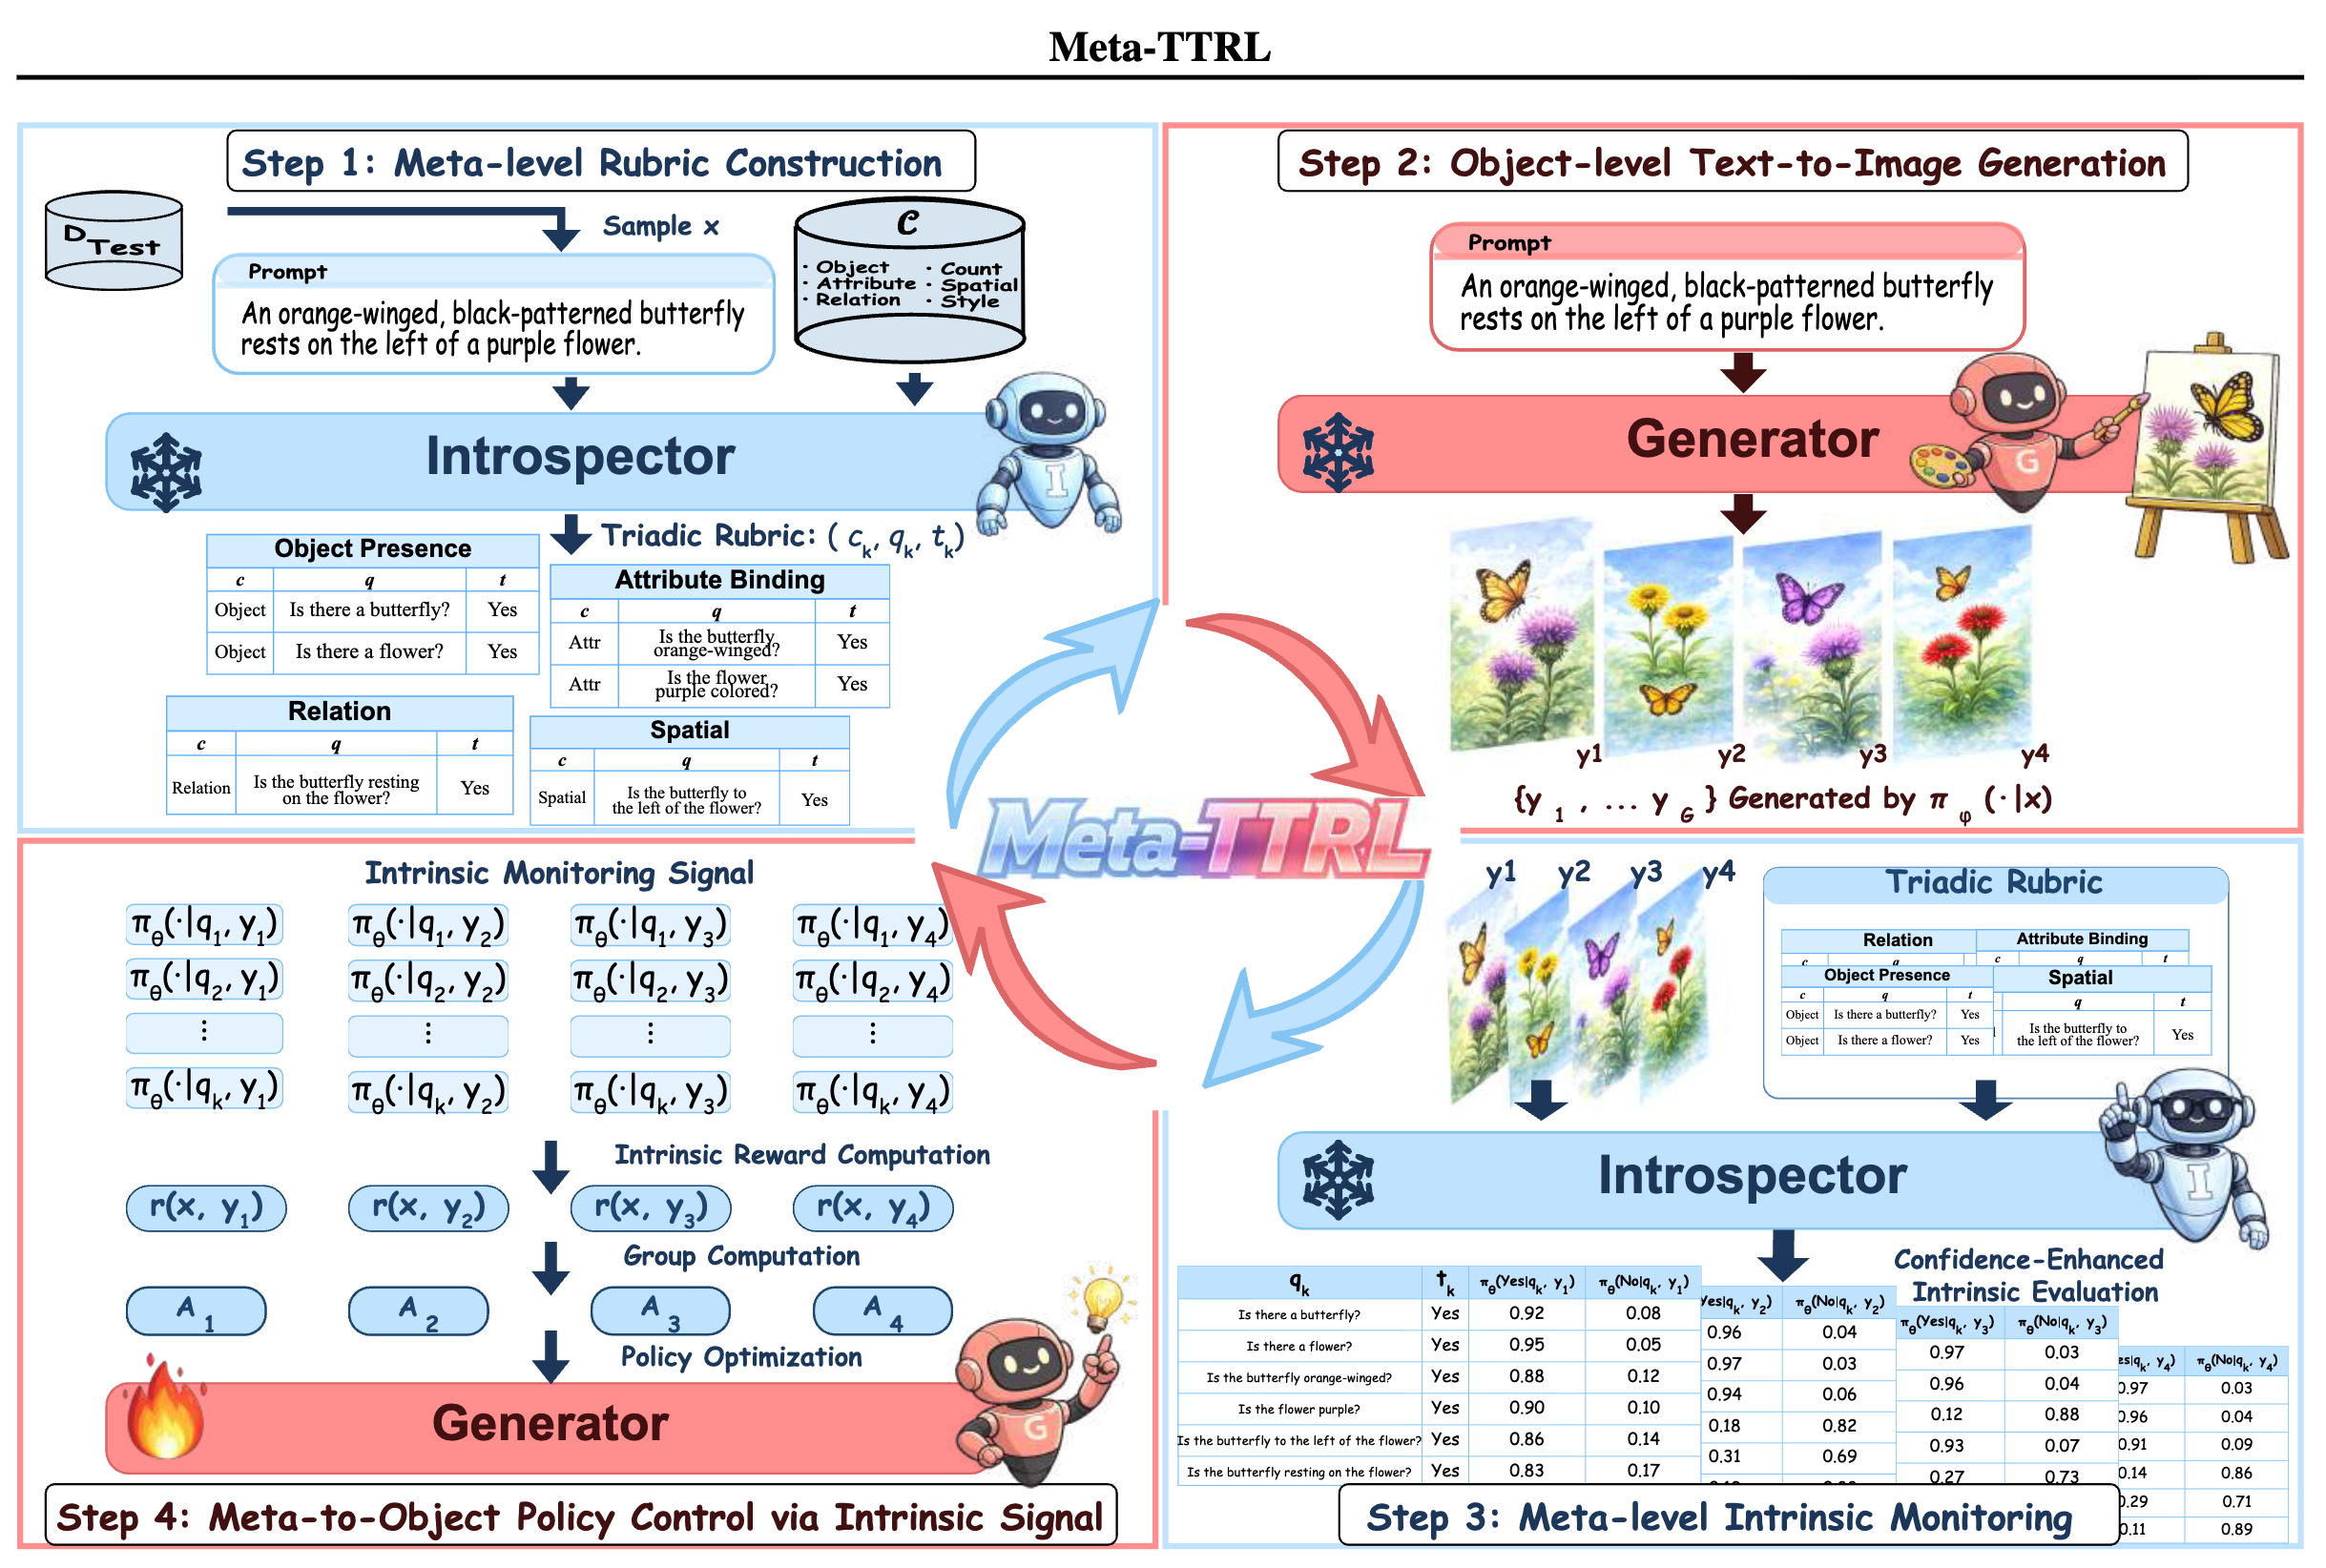
Meta-TTRL 借鉴了心理学中的“元认知(Metacognition)”理论——即人类对自身思考过程的认知与监督。既然 UMM 本身既懂视觉理解又懂图像生成,我们就可以在逻辑上把它拆成两个角色:
- 对象级生成器(Generator,策略 ):根据提示词生成图像,其参数会在测试时不断更新。
- 元级内省器(Introspector,策略 ):参数保持冻结,负责扮演“严厉的裁判”,利用自身的理解能力为提示词制定评分标准,并对生成器绘制的作品打分。
通过这两个角色的配合,形成了一个“生成-监控”的自我改进闭环。
执行步骤
第一步:元级量表构建(把复杂指令拆解成考卷) 如果让模型直接给一张复杂的图片打分,打分的结果往往模糊且不稳定。因此,内省器会先根据预设的 6 个认知维度 ,把用户的提示词拆解成一份结构化的“是非题考卷” 。例如,面对提示词 “一只橙翅黑纹的蝴蝶停在紫色花朵的左边”,内省器会根据每个评估维度 自动生成一系列验证问题 (如“图中有蝴蝶吗?”、“蝴蝶在花的左边吗?”)和对应的标准答案 。其中,代表评估维度 的第 个问题。
第二步:对象级文生图(平行创作多幅画作) 生成器根据当前的策略 ,针对提示词 一次性采样生成一组( 张)不同的候选图像 作为待批改的“答卷”。
第三步:元级内源监控(逐题批改与打分) 内省器拿着第二步生成的“答卷”,对每一张候选图像 进行逐题审阅。它会计算图像满足每个问题约束的置信度得分:
接着,将所有问题的得分通过几何平均汇总,得出这张图的最终内源奖励总分:
第四步:基于内源信号的策略控制(总结经验,更新大脑) 拿到每张图的奖励分数后,为了防止模型自己给自己打分时产生绝对数值上的偏差,Meta-TTRL 采用了组内相对策略优化(GRPO)算法。它不看绝对分数的高低,而是比较一组图片中“谁比平均水平更好”,计算出每张图的相对优势 :
最后,利用这个优势信号和防止模型走偏的 KL 散度正则项 ,通过梯度上升直接更新生成器的参数 。
四、实验与结果
实验设置
- 测试模型:为了验证方法的普适性,实验选取了涵盖三种不同架构范式的代表性 UMMs:Janus-Pro-7B、BAGEL 和 Qwen-Image。
- 评测基准:在三个高难度的文生图基准上进行了全面评测,包括考察指令遵循能力的 TIIF-Bench、考察复杂组合推理能力的 T2I-CompBench++(包含颜色、形状、纹理、2D/3D空间、数量等8个子维度)以及 DPG-Bench。此外,还引入了 GenEval 基准用于测试模型的分布外(OOD)泛化能力。
- 对比基线:主要与未经过测试时强化学习的原始基础模型进行直接对比,以衡量自我改进的净收益。
核心结论
- 全模型性能稳步提升:Meta-TTRL 在所有三个模型和三个基准上均取得了全面优势。即使像 Qwen-Image 和 BAGEL 这样自身已经过后训练的强力模型,依然能获得稳定提升。在 TIIF-Bench 上,Qwen-Image、BAGEL 和 Janus-Pro-7B 的平均得分分别绝对提升了 +2.01、+4.30 和 +5.41;在 T2I-CompBench++ 的八个子维度总分上,三者更是分别实现了 +10.34、+22.55 和 +109.25 的显著绝对增长。
- 空间与组合推理短板大幅补齐:在以往文生图模型最容易翻车的形状、纹理、空间位置和数量统计等维度上,Meta-TTRL 表现尤为亮眼。例如,Qwen-Image 在形状和 2D 空间维度上分别相对提升了 +4.28% 和 +5.17%;BAGEL 在形状、2D 空间和 3D 空间属性上分别相对提升了 +6.90%、+11.90% 和 +15.64%。
- 弱基线模型实现“逆袭式”暴涨:对于原本在组合推理上表现较弱的 Janus-Pro-7B,Meta-TTRL 带来了爆发式的相对提升——其颜色准确率相对提升 +52.50%,形状相对提升 +53.12%,纹理相对提升 +67.17%,2D 空间推理更是相对激增了 +106.36%(从 15.73 分跃升至 32.46 分),数量维度也相对提升了 +21.53%。
- 真正学到了本领,而非死记硬背(泛化能力出色):
- 在未参与训练的 GenEval 基准测试中,经过其他数据集测试优化后的三个模型均取得了显著的分数增长(例如 BAGEL 提升了最高 4.13 分,Janus-Pro-7B 提升了最高 3.34 分)。
- 在跨基准测试中(例如在 T2I-CompBench++ 上做测试时学习,然后直接去考 TIIF-Bench 和 DPG-Bench),Janus-Pro-7B 的成绩依然全面上涨(在 TIIF 上提升 3.03 分)。这证明模型通过 Meta-TTRL 真正掌握了通用的作画规律,并没有对特定测试题产生过拟合。
五、小结与展望
Meta-TTRL 为我们展示了一种极具性价比的 AI 进化范式:无需收集海量新数据去重新预训练,也不必外挂庞大的裁判模型,只需激活多模态模型自带的“理解力”去审视自己的“创造力”,就能在使用过程中越用越聪明。如果我们将目光投向商业落地,这种“边用边学、精准控制组合属性”的技术在电子商务(E-Commerce)领域有着极其广阔的想象空间:
- 高精度的商品场景图与多元素组合生成 电商卖家在制作商品海报时,对空间位置、数量和属性绑定有着极高的要求(例如:“将这款磨砂黑咖啡机放在木质吧台的右侧,左边摆放两只透明玻璃杯,背景是清晨阳光”)。传统文生图模型经常会出现“颜色串台”(把杯子画成黑色)或“空间错乱”。Meta-TTRL 的“元级量表构建”天然契合电商的复杂提示词,它能把商家的排版要求自动拆解成物体、属性、空间、数量等核查清单,确保生成的商品图严格遵循商业排版规范。
- 新品类与流行趋势的“零样本”快速自适应 电商行业的审美风向和爆款品类变化极快(比如突然流行某种特定剪裁的服饰或特定风格的家居布景)。传统的模型微调(如训练专属 LoRA)需要收集数据、人工打标并耗费专门的训练周期。引入 Meta-TTRL 后,电商设计平台可以在运营人员日常输入提示词生图的过程中,直接利用测试时强化学习动态调整模型参数。当运营人员连续生成某类春季新品海报时,模型在几次自我反思后就能迅速掌握该品类的材质纹理与光影规律,实现“越用越懂行”的持续进化。
- 跨店铺的品牌视觉资产沉淀 正如实验中的跨基准泛化结果所示,Meta-TTRL 学到的是能力级别的提升。在电商场景下,这意味着为一个品牌店铺服务的多模态模型,在日常生成营销图的过程中,能够通过内源监控不断内化该品牌的特定视觉语言与构图偏好。无需外部人工频繁干预打分,每个品牌都能在日常使用中低成本地“养成”一个高度契合自身调性的专属 AI 视觉设计师。