

 197浏览
京东零售AI Infra团队聚焦大规模LLM-based多智能体强化学习(MARL)的基础设施空白,提出图驱动 Rollout-Training 协同框架FlexMARL,系统性解决MARL特有的Rollout负载不均、关键路径同步屏障、动态训练需求三大挑战。FlexMARL已落地电商多智能体助手场景,实现最高7.3倍端到端训练加速与5.6倍硬件利用率提升。
相关论文已被系统领域顶会 ACM SIGOPS Annual Technical Conference(ATC'26,CCF A类)正式接收,是京东首篇ATC论文。本年度ATC共收到973篇投稿,最终录用135篇,接收率仅13.9%,创历史新低。
1 背景与挑战
随着大语言模型(LLM)的快速发展,基于角色分工的多智能体系统已成为解决复杂任务的重要范式。与此同时,强化学习作为LLM后训练的核心技术,与多智能体系统结合形成的多智能体强化学习(Multi-Agent Reinforcement Learning,MARL),能够让智能体群体通过交互经验协同学习策略,释放协作智能,已在代码生成、数学推理等场景展现出显著价值。
然而,当前MARL领域更多聚焦算法层面创新,例如通信协议、协同优化、奖励函数设计等,支撑大规模MARL的训练 Infra尚未被充分探索。与单 Agent RL 不同的是,MARL 中的 Agent 并不是彼此独立运行,需要多个 Agent 之间的连续交互形成完整轨迹。因此,Agent 的调用频率、交互路径和训练时机都会随着任务动态变化。为了分析这些特征对AI Infra带来的影响,我们对真实电商多智能体助手工作负载进行了 Profiling,并总结出三个MARL特有的的核心挑战。
挑战一:Rollout 负载明显不均
多智能体系统通常根据功能划分不同角色,不同 Agent 的 Rollout 负载明显不均衡,核心 Agent 会出现在大量交互路径中,而辅助 Agent 只会在少数情况下被调用。在选取三个代表性 Agent 统计请求队列后发现,少量核心 Agent 处理了超过 76% 的 Rollout 请求,其他 Agent 合计处理不到 24%。在统一资源配置下,高负载 Agent 的请求持续排队,而低负载 Agent 的推理资源没有被充分利用,最终拖慢整个交互轨迹的生成。
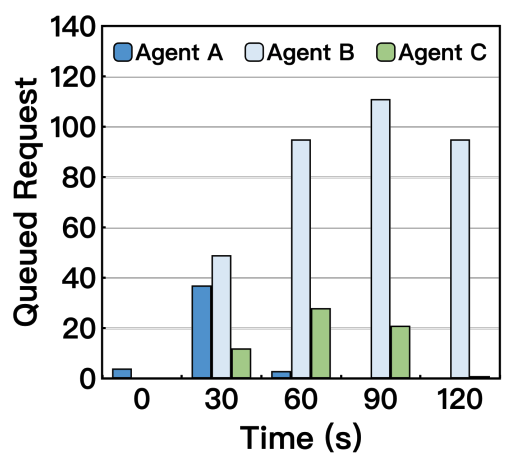
图一:不同 Agent 的排队请求数量明显不均
挑战二:关键路径同步屏障
不同任务的复杂度以及 Agent 决策路径不同,使得多智能体交互存在明显的长尾延迟。实验中,大多数请求能够较快完成,但最长用户查询响应时间接近170 秒。在传统同步训练方式下,策略更新必须等待所有轨迹全部收集完成才能启动,最慢的交互轨迹会阻塞整个训练流程,导致昂贵的算力资源长时间空转,而MARL 中 Agent 依赖进一步放大了这种长尾问题。
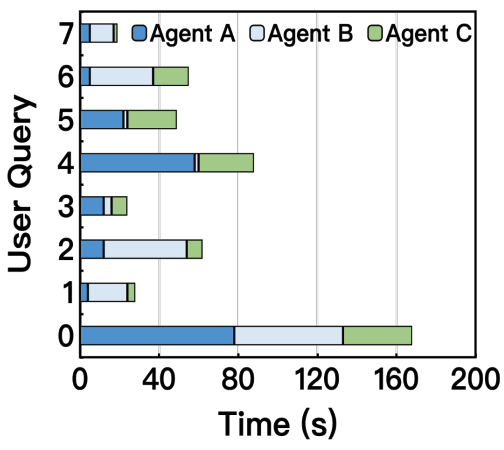
图二:多智能体 Query Response Time 呈长尾分布
挑战三:训练需求动态变化
每个训练步骤中,并不是所有 Agent 都需要同时进行策略优化,只有累积了足够训练样本的 Agent 才会参与当前阶段的梯度计算。若采用静态资源分配策略,为每个Agent预分配固定算力与显存,非激活Agent占用的资源则被浪费。初步实验显示,这种静态资源分配方式下,策略训练阶段的平均硬件利用率仅为 18.8%,资源浪费严重。
2 核心观察
我们调研发现,现有 RL 训练框架无法同时解决上述三个挑战:
- 一类是 OpenRLHF、veRL、AReaL 等通用强化学习框架。这类系统已经对 Rollout、Training 以及二者之间的协作进行了大量优化,但均面向单智能体场景设计。因此,它们难以感知 MARL 中的跨 Agent 依赖关系,也无法针对不同 Agent 的负载偏斜和动态训练激活进行调度。
- 另一类是已经支持多智能体训练的 MARL 专用框架(如MARTI)。它们能够运行多个 Agent,并支持基本的多智能体交互和策略训练,但本质是单智能体RL框架的增量扩展,缺乏针对MARL特性的端到端优化,且不支持跨节点大规模部署,仅能承载小规模策略模型,无法适配工业级负载。
为克服现有工作的不足,充分解决Rollout 负载不均、关键路径同步屏障以及训练需求动态变化的挑战,我们对工作负载进一步分析,发现这些挑战并不是彼此独立的,其深层根源统一指向 MARL 天然的图结构。MARL 真正的执行单元并不是一个孤立请求,而是由 Agent invocation(顶点)、数据依赖(边)、策略版本共同构成的执行图。从这一视角重新审视前面的三个挑战,可以发现它们实际上对应执行图的三个不同特征。
观察一:负载倾斜源于图的拓扑度数分布
不同顶点的入度、出度存在天然差异,核心智能体对应图中的高度数顶点,处于多数交互路径的关键位置,辅助智能体对应低度数顶点,仅在少数分支路径中被触发。这种负载不均是图拓扑的固有属性,传统基于请求的均匀调度策略,只能在单个智能体内部做简单的负载分发,无法消解拓扑结构本身带来的全局性负载倾斜,因此核心智能体的排队瓶颈始终存在。
观察二:同步屏障源于图的关键路径长度差异
多智能体交互的整体采样时长,不由单个智能体的调用耗时决定,而由整条依赖链路中最长的路径,即图的关键路径(critical path)决定。不同任务对应的关键路径耗时差异极大,形成了响应延迟的长尾分布,最终导致严重的流水线气泡和同步阻塞。
观察三:资源浪费源于图的稀疏子图激活
训练阶段也可以理解为对图中部分节点的动态激活。只有当某个 Agent 已经积累足够经验后,对应节点组才需要参与 policy optimization。不同 Agent 在不同时间达到训练条件,因此每个阶段真正需要执行训练的只是整张图中的一个动态变化的稀疏子集。传统静态资源分配策略相当于为全图所有顶点常驻保留资源,大量资源被非激活的顶点长期占用而无法复用,导致了较低的硬件利用率。
3 系统设计
基于上述观察,我们提出 FlexMARL,一套面向大规模MARL 的图驱动 Rollout-Training 协同框架,核心思路并不是针对三个挑战分别优化,而是显式表示 MARL 的执行图结构,再利用这一结构统一指导 Rollout和Training的设计。
FlexMARL包含四个相互配合的组件:MEG Store、Rollout Engine、Joint Orchestrator 和 Training Engine。MEG Store 将多智能体执行图实例化,并作为整个系统的数据中枢,完整工作流程为Rollout Engine 根据依赖关系生成多智能体交互轨迹,增量写入MEG Store,并动态均衡不同 Agent 的推理负载;Joint Orchestrator 按智能体粒度异步调度经验至训练端,在保证策略版本一致性的同时实现Rollout 和 Training并行;Training Engine 则根据当前活跃 Agent 动态分配训练资源完成策略优化,更新后的模型同步回所有推理实例,开启下一轮迭代。
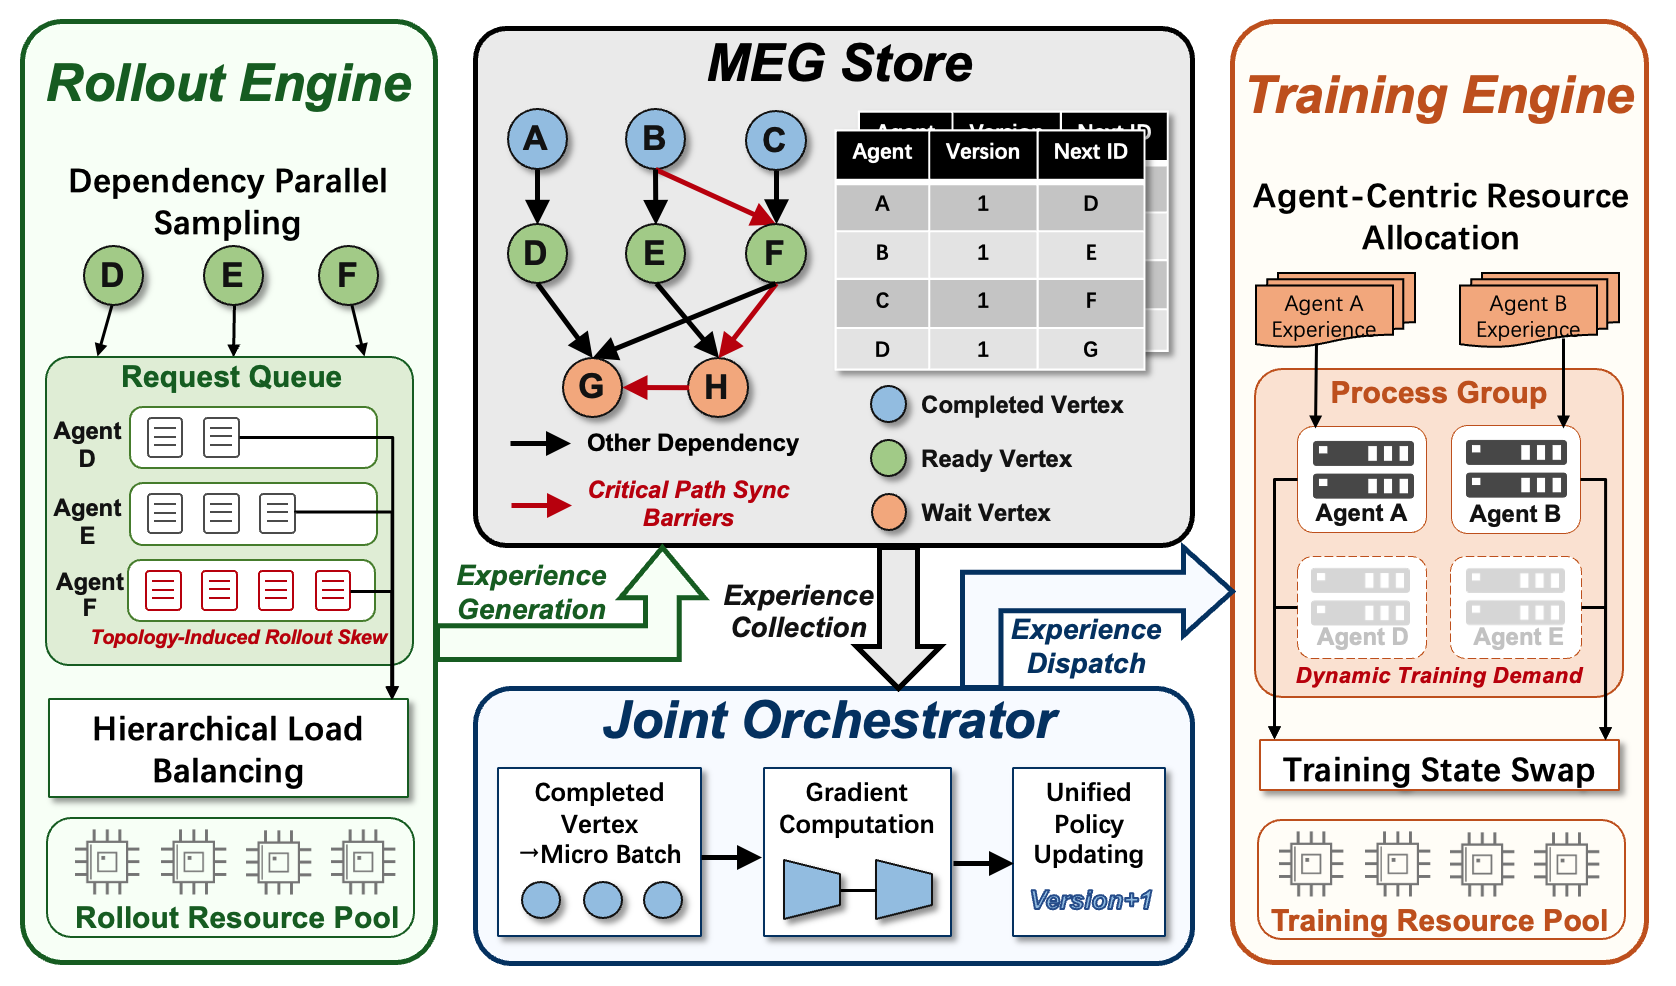
图三:FlexMARL 系统架构
3.1 MEG Store:统一表示多智能体执行关系
传统 RL 系统通常将经验组织成扁平的 trajectory 或 batch。但对于 MARL,这种表示方式无法直接体现不同 Agent 之间的数据依赖、调用关系以及 policy version。FlexMARL 因此提出 Multi-Agent Execution Graph(MEG),通过有向图描述MARL执行逻辑,顶点代表一次智能体调用,包含策略版本、输入提示、输出响应、奖励等完整信息,边代表数据依赖关系,即下游智能体必须等待上游智能体输出完成后才能执行。
MEG在 Rollout 和 Training 中具有不同视角:
- Rollout view:顶点按拓扑顺序执行,边约束数据依赖,决定智能体的就绪时机与调用链路;
- Training view:完成的顶点按智能体ID与策略版本分组,边不再约束执行,各智能体独立进行策略优化。
MEG 在实现时将被实例化为 MEG Store。MEG Store 采用去中心化的多表组织方式,以节点为粒度存储 Agent ID、policy version、sample ID、输入输出、reward 以及数据是否就绪等状态。简单类型直接存储在表中,字符串、列表和 tensor 等复杂对象通过引用访问,在保持查询效率的同时支持不同 MARL 算法扩展数据字段。
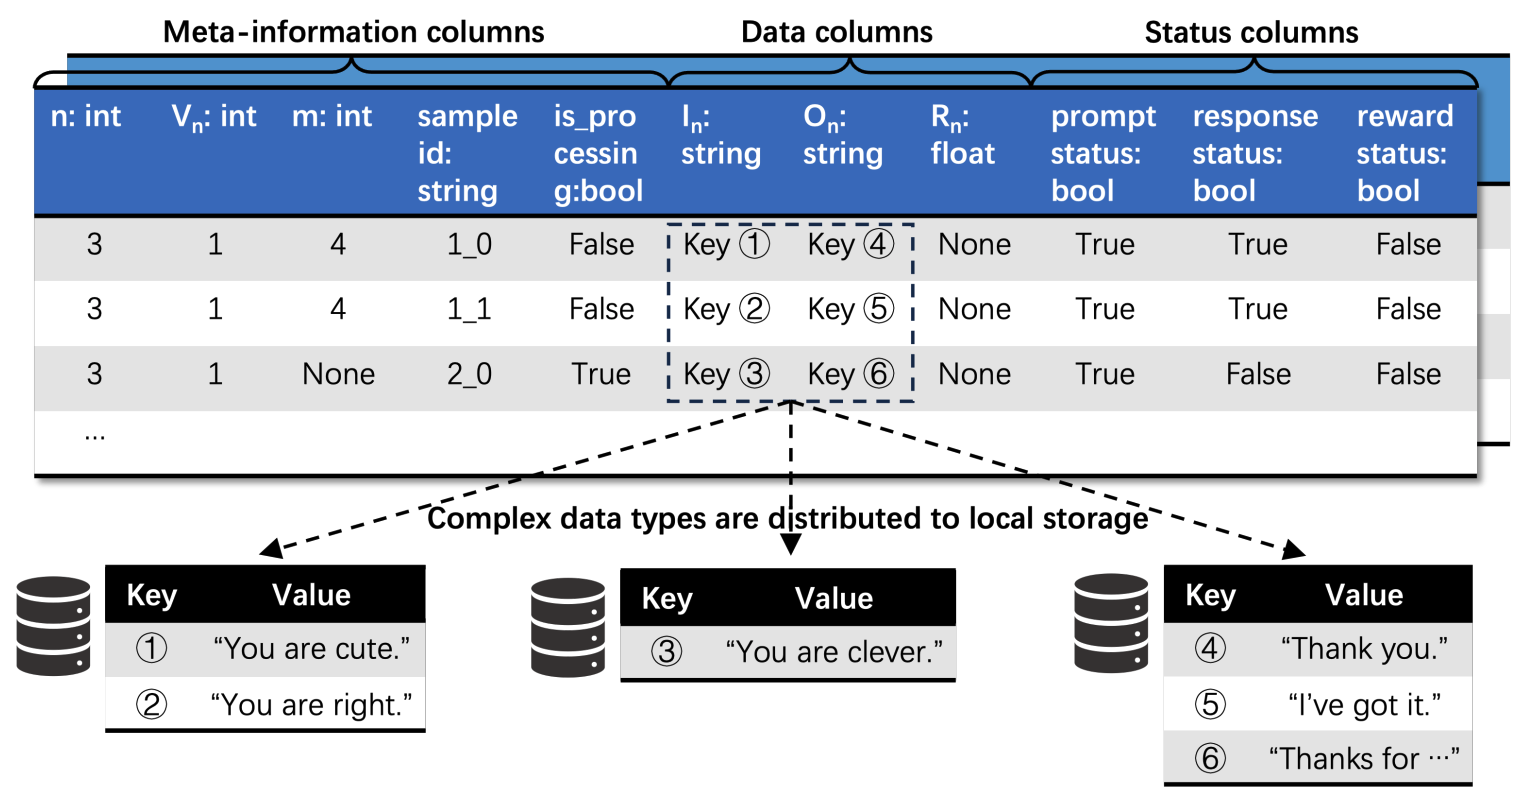
图四:MEG Store的去中心化多表结构
3.2 Rollout Engine:依赖并行采样与层次化负载均衡
基于依赖的并行采样:FlexMARL 按照 MEG 中的依赖关系调度,只要一个 Rollout 请求的上游依赖已经满足,就可以立即发送给下游 Agent,而不需要等待当前 Query 或其他 trajectory 全部完成。因此,不同 Query 之间以及同一 Query 的不同分支都可以并行推进。Agent 生成结果后,Rollout Engine 将输出及对应状态写回 MEG Store,并根据图中的后继关系继续触发下游节点。
层次化负载均衡:仅增加并行度并不能解决不同 Agent 之间天然存在的负载差异。因此,FlexMARL 进一步从 Agent 内部和 Agent 之间两个层次进行动态负载均衡。
- Agent 内负载均衡:每个 Agent 可以部署多个 inference instance。Rollout Engine 基于最小堆维护不同实例的请求队列,将新请求发送给当前负载最低的实例,实现单智能体内部的请求均衡分发,同时支持超时取消、失败重入等容错机制。
- Agent 间负载均衡:Rollout Engine 监控不同 Agent 的请求队列长度,当高负载 Agent 与低负载 Agent 之间的负载差距达到阈值后,系统会将部分 inference instance 从低负载 Agent 转移到高负载 Agent,同时保证每个 Agent 至少保留一个实例。新实例通过模型权重传输切换为目标 Agent,从而动态调整不同 Agent 的推理容量。
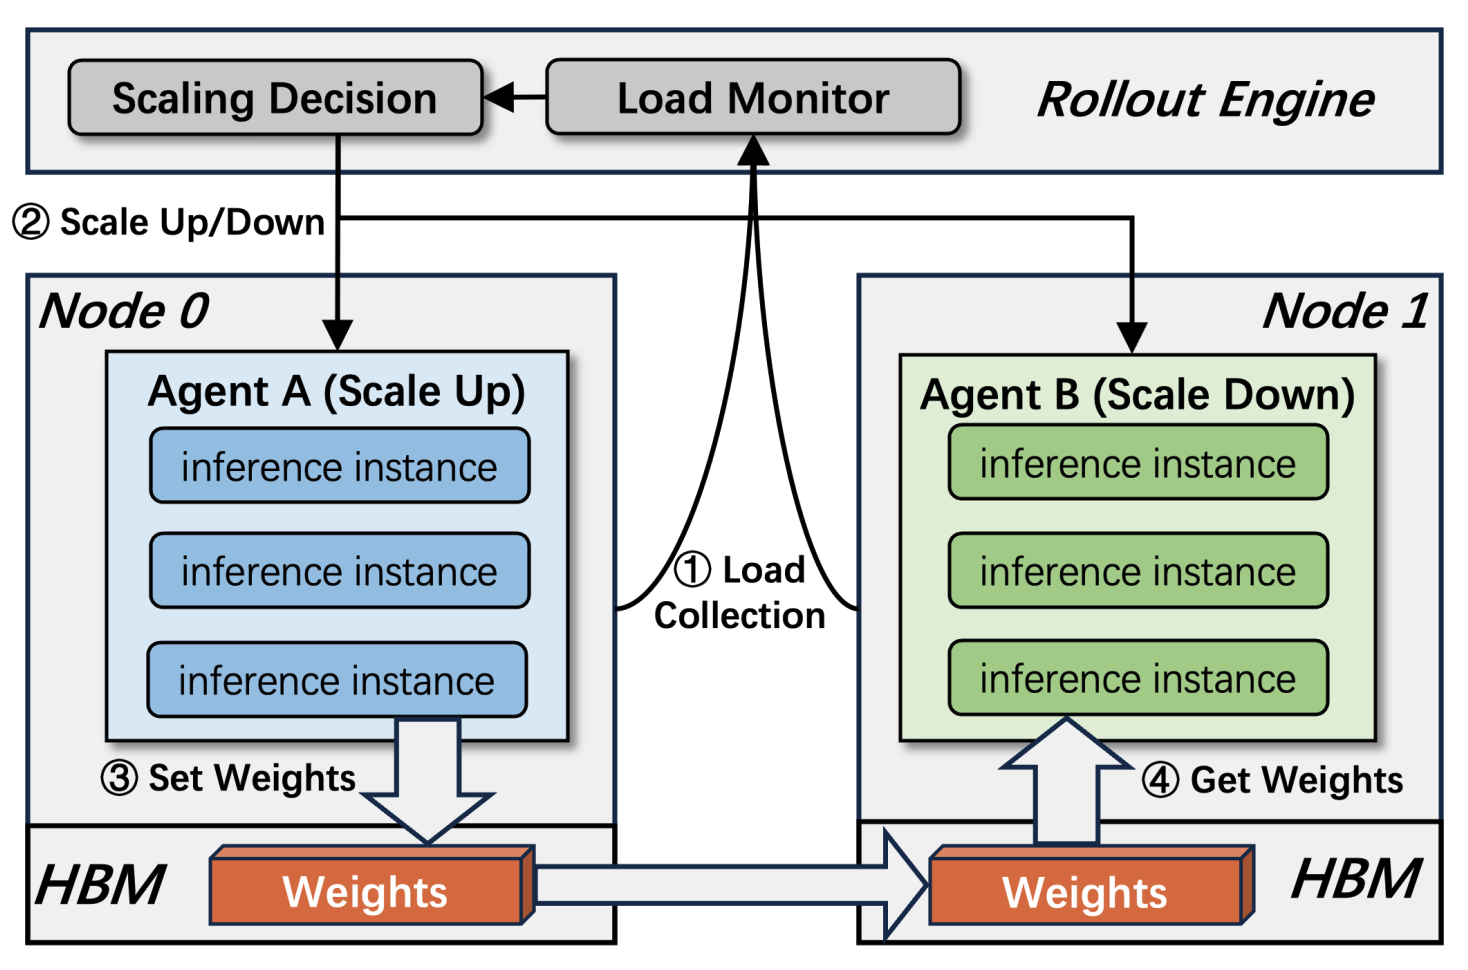
图五:根据 Agent 请求队列动态调整 inference capacity
3.3 Joint Orchestrator:基于分离架构的Agent-level异步流水线
异步流水线:现有 MARL 系统常采用 colocated 架构,Rollout 和 Training 共用同一资源池,并按阶段交替使用设备。但两个阶段的资源特征并不相同:Rollout 更容易受到显存和推理吞吐影响,Training 则需要更强的计算能力。更重要的是,当 Rollout 存在长尾路径时,训练设备需要等待整个 batch 完成。为此,FlexMARL采用分离架构将 Rollout 和 Training 部署在独立资源池,使两者能够分别扩展,并进一步设计 Agent-level异步流水线。当某个 Agent 在 MEG Store 中已经积累了足够的经验后,Joint Orchestrator 不再等待整个 batch 完成,而是直接组成 micro batch,并交给对应 Agent 的训练进程提前计算梯度。此时其他 Agent 的 Rollout 可以继续执行,从而将关键路径的长尾延迟隐藏在训练流程中,有效降低同步等待开销。
训推一致性:直接异步更新不同 Agent 的 policy 会带来 policy staleness。特别是在 MARL 中,不同 Agent 相互依赖,如果一条 trajectory 中混用了不同版本的策略模型,采集到的经验将不再对应同一个一致的多智能体策略状态。为此,FlexMARL 将 gradient computation 和 policy update 解耦。各 Agent 可以提前计算并缓存梯度,但在一个完整 batch 结束前不立即更新参数,在此期间 policy model 保持冻结。当整个 batch 处理完成后,再聚合缓存梯度并统一更新策略版本。更新后的模型随后同步到全部 inference instance,用于下一轮 Rollout。该机制保证了同一轮采样中所有智能体的策略版本一致,避免多智能体依赖路径上的版本偏差导致训练效果下降。
3.4 Training Engine:以Agent为中心的按需资源分配
资源动态绑定:由于不同 Agent 获得训练样本的时间并不固定,Training view 中真正需要执行策略优化的 Agent 集合是动态变化的。FlexMARL 因此不再为每个 Agent 固定绑定训练设备,而是以 Agent 为粒度组织训练 process group。一个 Agent 累积到足够训练样本后,对应 process group 被激活,并调度到当前可用设备,完成当前训练任务或暂时没有新 experience 后,进程被终止,相应计算资源和 HBM 立即释放回资源池,训练状态从设备显存卸载至主机内存。这种“suspend-to-destroy”设计避免了非激活Agent对资源的静态占用,让资源分配随Agent的激活状态动态变化,匹配MARL稀疏的训练激活特征。
训练状态高效交换:为了支持不同Agent训练状态(模型权重、优化器状态等)的高效换入换出,FlexMARL 进一步实现了一套 Location-agnostic Set/Get API。系统以 key-value 方式访问数据对象,调用方通过稳定的逻辑 key 获取对象,底层 runtime 根据元数据定位其实际物理位置,Agent恢复部署时优先调度至原节点以降低迁移开销,并根据场景选择 D2D、D2H、H2D 或跨节点 RDMA 等传输路径,上层不需要直接管理不同设备和不同存储层级之间的地址与数据迁移。该机制使我们可以在有限硬件资源上部署大量智能体,同时保证训练连续性。
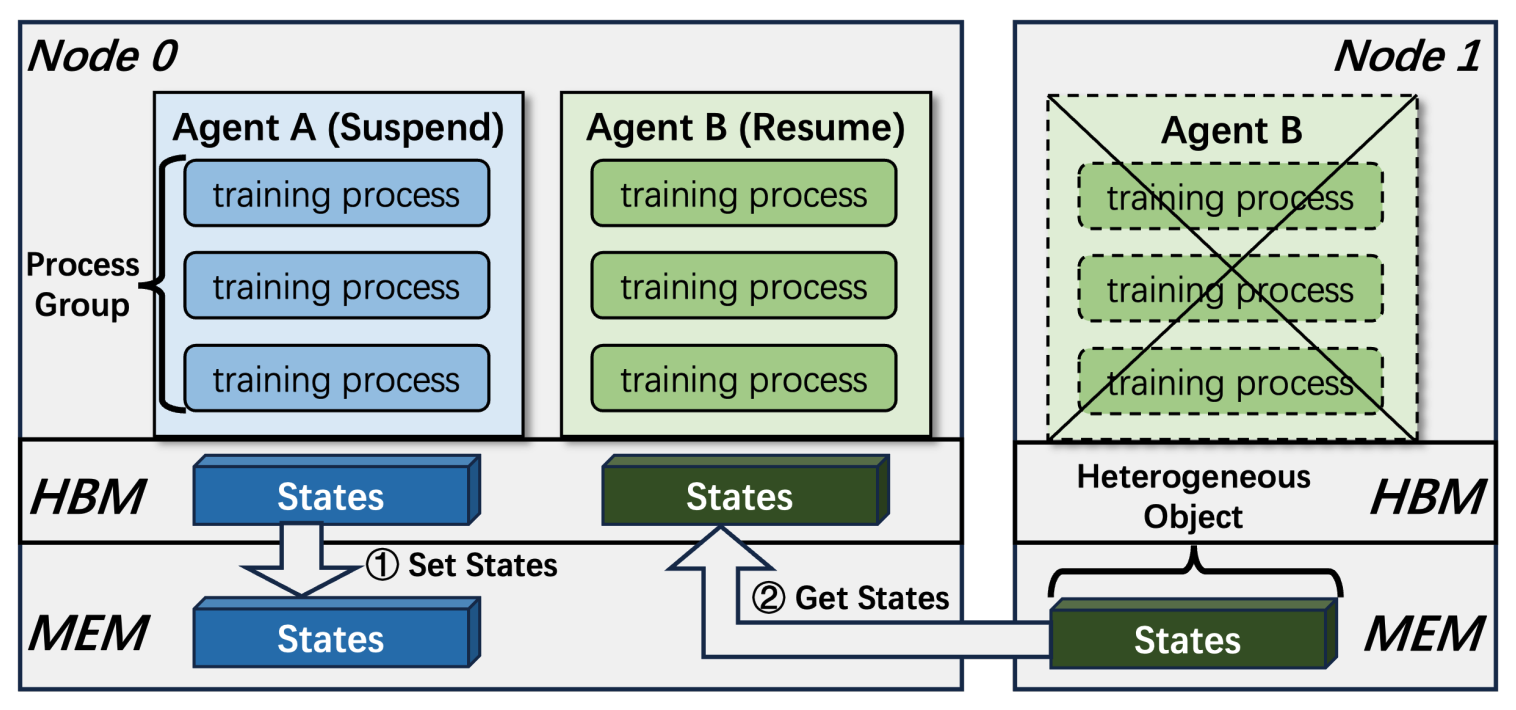
图六:不同Agent的训练状态交换
4 性能评估
4.1 端到端训练性能
FlexMARL在商家助手(MA)与采销助手(CA)两个真实工业数据集上均取得最优端到端性能。在 MA 数据集上,FlexMARL 将单步耗时降低到 126.1s,实现了高达 7.3× 训练加速和 7.6× 吞吐提升。在 CA 数据集上,FlexMARL 将单步耗时降低到 78.8s,实现了 5.6× 训练加速和3.1× 吞吐提升。相比业界SOTA的MARTI (ICLR’26),FlexMARL平均训练速度提升1.4倍,吞吐量提升1.3倍,性能收益同时来自Rollout阶段的并行与弹性调度,以及Training阶段的按需资源分配。
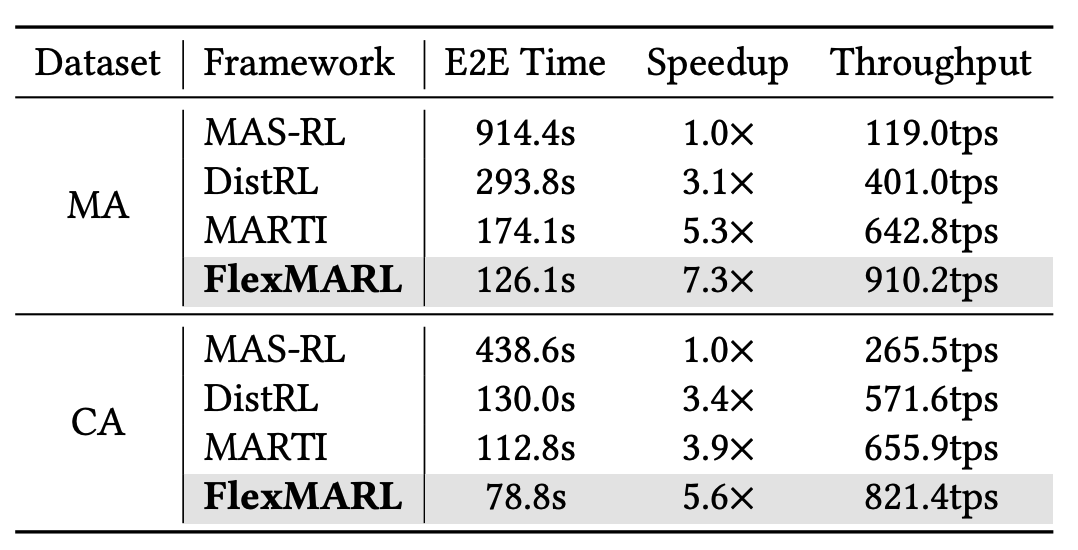
表一:不同 MARL 框架在 MA 和 CA 数据集上的端到端训练性能
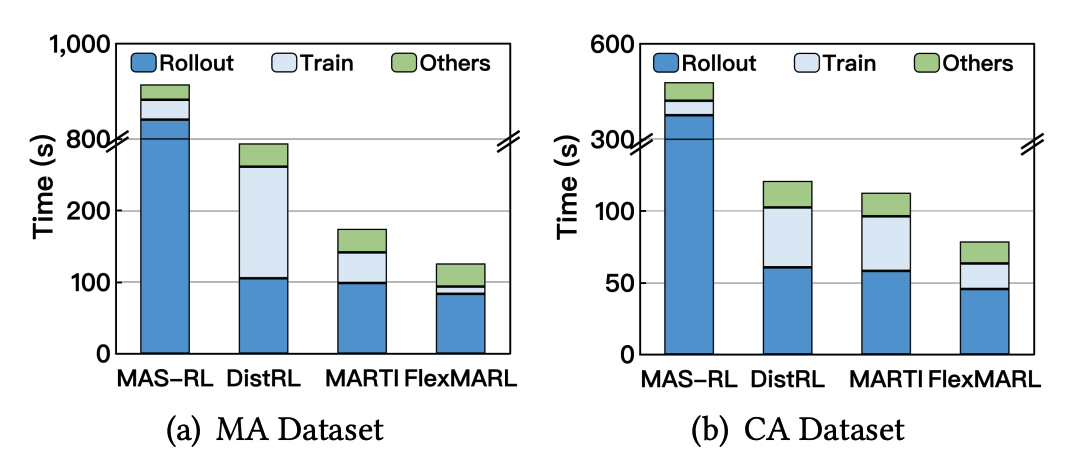
图七:不同 MARL 框架在 MA 和 CA 数据集上的 Time Breakdown
4.2 负载均衡
分层负载均衡机制显著缓解了核心智能体的排队瓶颈。以 MA 数据集的核心 Agent B 为例,FlexMARL 在约 90 秒内即可完成全部待处理请求,而 DistRL 和 MARTI 分别需要约 244 秒和 159 秒,对应 2.7× 和 1.8× 的加速。FlexMARL 的请求队列会在并行采样开始后快速增加,但随后也能更快下降。原因在于,基于依赖的并行采样提供了更多可并行执行的请求,而层次化负载均衡又能够及时增加高负载 Agent 的 inference instance,使这些并发请求能够被快速消费,而不是堆积在核心 Agent 上。
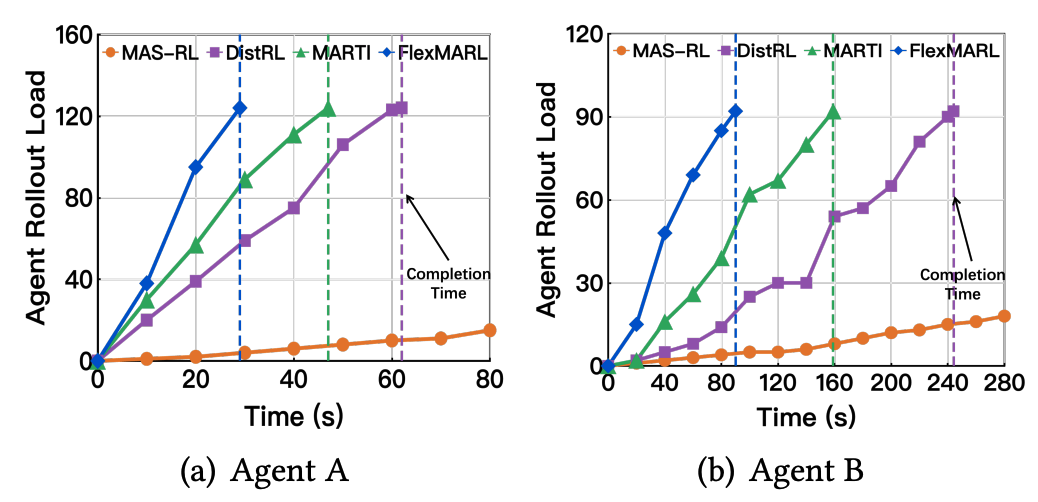
图八:MA数据集代表性 Agent的Rollout 负载
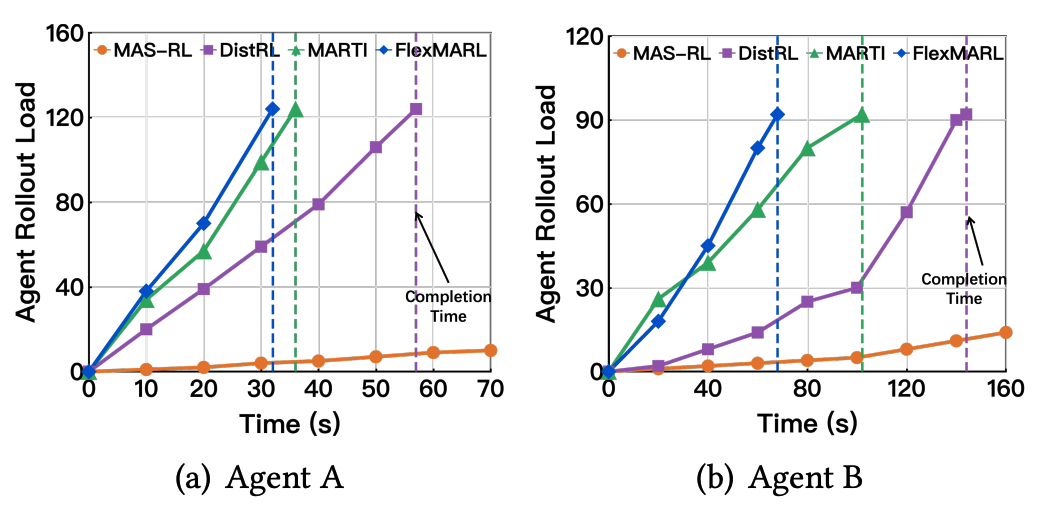
图九:CA数据集代表性 Agent的Rollout 负载
4.3 消融实验
FlexMARL分别移除层次化负载均衡、异步流水线和按需资源分配,验证不同设计对最终性能的贡献。去除负载均衡后,训练吞吐下降 19.8%–25.5%;去除 Agent 级异步流水后性能下降最明显,MA 和 CA 上的 E2E time 分别增加 103.2% 和 57.5%;移除按需资源分配,训练速度也出现下降,资源闲置问题复现。这说明减少核心 Agent 的请求积压以及消除关键路径带来的 Rollout-Training 同步等待,是 FlexMARL 性能提升的重要来源。
此外,系统优化不能以改变 MARL 的训练效果为代价。为此,FlexMARL比较了 SFT-only、同步 MARL 和 FlexMARL 的最终任务准确率。FlexMARL的任务准确率与同步MARL基线基本持平(MA数据集90.1% vs 90.3%),相比SFT-only基线准确率明显提升,证明异步流水线机制在提升效率的同时,保证了MARL的策略优化效果,没有一致性损失。
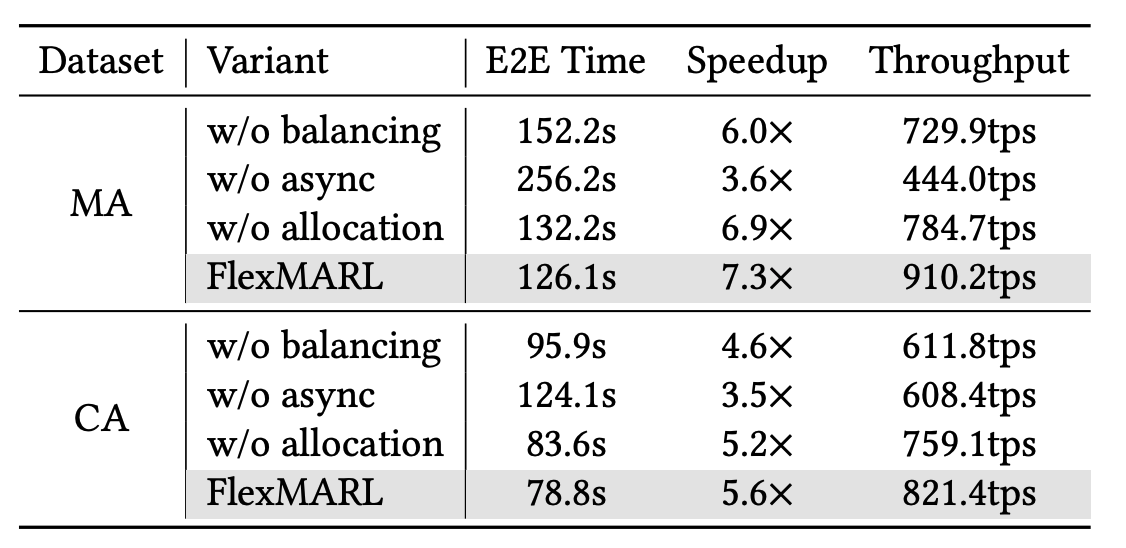
表二:不同组件的消融实验
4.4 可扩展性
FlexMARL 在大规模异构场景下表现出优异的可扩展性。其中,3×32B + 7×14B 的异构配置实现 334.8 tokens/s 吞吐,15 个 14B Agent 的场景达到 754.2 tokens/s,而现有MARL框架无法支撑大规模模型参数的跨节点部署。这组实验表明FlexMARL 的优化并不局限于固定规模或同构 Agent,能够覆盖 Agent 数量增加、模型规模扩大以及不同模型混合部署等工业级MARL训练负载。
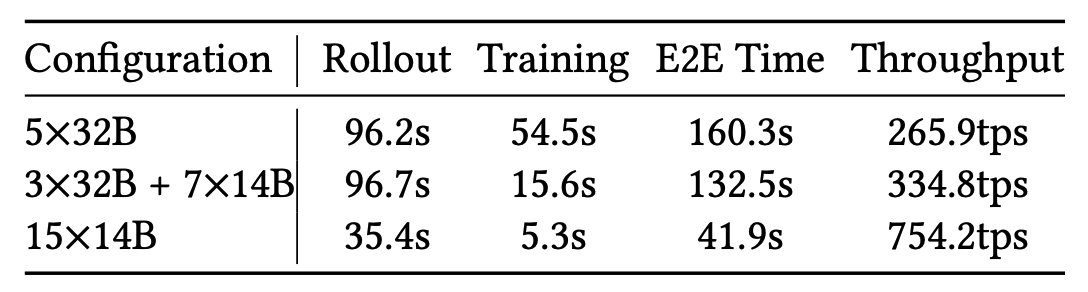
表三:大规模异构场景的部署结果
5 B端AI 业务落地
一阶段成果:基于FlexMARL框架的相关优化,B端AI业务模型从 5×3B 扩展至 3×14B,训练总耗时从30天压缩至6.5小时,推动京麦pop助手准确率提升3.9%;
二阶段成果:支持B端AI业务实现 32B+2×14B+10B 混合多智能体训练,基于依赖并行采样、层次化负载均衡、异步流水线和训练资源动态绑定等优化,进一步将端到端训练性能提升3倍,推动采销助手准确率提升4.0%(86.4%->90.4%),Master Agent调度准确率提升3.8%(86.6%->90.4%);
未来FlexMARL将支持 AI Native全托管 训练,系统中包含Master以及价格 - 营销 - 广告- 素材- 搜索五个大域Agent,每个域Agent分别管理对应场景所有子Agent和工具,预计规模将扩展到70B模型,以洞察站外热点、为一批商品重新核算价格策略、调整价格、生成并投放广告计划,最终面向消费者生效。
6 总结与展望
本工作面向大规模多智能体强化学习场景,针对 Rollout 负载不均、关键路径同步屏障以及训练需求动态变化等问题,提出了图驱动的 Rollout-Training 协同框架 FlexMARL。通过MEG描述 Agent 调用关系和数据依赖,并围绕 Rollout、调度与 Training 进行端到端系统优化,FlexMARL 在真实电商多智能体任务和生产集群上验证了方案的有效性,实现最高 7.3× 的端到端训练加速,并显著提升硬件资源利用率。
随着大模型应用从单 Agent 逐步走向多 Agent 协作,RL Infra面临的系统问题也在发生变化,Rollout 路径、训练时机和资源需求都更加动态。传统围绕单模型构建的训练框架,已经难以仅依靠局部优化充分释放系统效率。FlexMARL 的实践表明,将多智能体执行关系纳入系统设计,并在数据组织、任务调度和资源管理之间进行协同优化,是支撑大规模 MARL 训练的一条可行路径。
未来,京东零售 AI Infra 团队将继续围绕强化学习和多智能体训练基础设施开展系统优化,进一步探索更多 Agent 数量、更大参数模型以及更复杂异构场景下的训练能力,为真实业务场景提供高效、稳定的训练框架支撑。